初等考試 107 年 初等考試 統計學大意 考古題與詳解
本卷共 40 題,其中 38 題附有本站自撰的逐題詳解。題目與標準答案取自考選部「考畢試題查詢平臺」的公開資料;詳解由本站撰寫並標註出處。本頁列出全部題目與標準答案,並免費試讀前 3 題的詳解;其餘詳解在線上作答時逐題顯示。
1107 年公務人員初等考試試題 頁次:8-1等 別:初等考試②本科目共40 題,每題2.5 分,須用2B 鉛筆在試卡上依題號清楚劃記,於本試題上作答者,不予計分。③可以使用電子計算器。④作答時請參閱附表。1 已知 P(A | B) = 0.4 , P(B) = 0.6 , P(A ∩ B c ) = 0.2 ,則 P(A ∪ B) = ?
- (A) 0.6
- (B) 0.7
- (C) 0.8
- (D) 0.92 一袋中有三枚 10 元硬幣,其中一枚兩面皆為“10 元”,另一枚兩面皆為“國父人像”,第三枚有一面是“10 元”,另一面是“國父人像”,今由袋中隨機取出一硬幣,連擲 3 次皆為“10 元”面朝上,請問取出之硬幣兩面皆為“10 元”硬幣的機率為何?
正解:(C)
逐題詳解(免費試讀)
✅ (C) P(A∩B)=P(A|B)P(B)=0.4×0.6=0.24;P(A)=P(A∩B)+P(A∩Bᶜ)=0.24+0.2=0.44;P(A∪B)=0.44+0.6-0.24=0.8。
❌ (A) 0.6 只是 P(B),未加入 A 的部分。
❌ (B) 0.7 與加法定理的計算結果不符。
❌ (D) 0.9 高估了聯集機率。
📚 出處:機率論(條件機率與加法定理)
20.92 一袋中有三枚 10 元硬幣,其中一枚兩面皆為“10 元”,另一枚兩面皆為“國父人像”,第三枚有一面是“10 元”,另一面是“國父人像”,今由袋中隨機取出一硬幣,連擲 3 次皆為“10 元”面朝上,請問取出之硬幣兩面皆為“10 元”硬幣的機率為何?
- (A) 1/3
- (B) 1/2
- (C) 8/9
- (D) 7/83 已知 200 筆樣本資料呈現平均數 = 50,標準差 = 10 的鐘形分配,則約有多少筆資料介於 30 與 60 之間?
正解:(C)
逐題詳解(免費試讀)
✅ (C) 設 A=雙 10 元面。P(3 次皆 10 元|A)=1、雙人像=0、一正一反=(1/2)³=1/8。後驗機率=(1/3×1)/[1/3×1+1/3×0+1/3×1/8]=(1/3)/(3/8)=8/9。
❌ (A) 1/3 是未觀察結果前的先驗機率。
❌ (B) 1/2 未使用貝氏更新。
❌ (D) 7/8 與分母 3/8 的計算不符。
📚 出處:機率論(貝氏定理)
37/83 已知 200 筆樣本資料呈現平均數 = 50,標準差 = 10 的鐘形分配,則約有多少筆資料介於 30 與 60 之間?
- (A) 161
- (B) 163
- (C) 165
- (D) 1684 隨機變數 X 服從二項分配, n = 10 , p = 0.2 ,則 P(| X - 2 |< 2) = ?
正解:(B)
逐題詳解(免費試讀)
✅ (B) 30 與 60 分別為 μ-2σ 與 μ+σ;鐘形分配下該區間機率≈0.475+0.34=0.815,200×0.815≈163 筆。
❌ (A) 161 與經驗法則的比例不符。
❌ (C) 165 略高於 0.815 的估計。
❌ (D) 168 相當於 84% 的比例。
📚 出處:統計學(經驗法則 68-95-99.7)
41684 隨機變數 X 服從二項分配, n = 10 , p = 0.2 ,則 P(| X - 2 |< 2) = ?
- (A) 0.7717
- (B) 0.7327
- (C) 0.7422
- (D) 0.7543⎧1 − Kx, 0 < x < 25 一隨機變數 X 的機率密度函數為 f(x) = ⎨ 。K 值為:⎩ 0 , 其他
正解:(A)
本題附有逐題詳解,線上作答後即可看到。
50.7543⎧1 − Kx, 0 < x < 25 一隨機變數 X 的機率密度函數為 f(x) = ⎨ 。K 值為:⎩ 0 , 其他
- (A) 1.0
- (B) 0.5
- (C) 1.5
- (D) 2.06 X1 , X 2 , ..., X n 為來自 Poisson 分配,其參數為 λ 的一組隨機樣本,則此 Poisson 分配之標準差的最大概似估計量為何?
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
62.06 X1 , X 2 , ..., X n 為來自 Poisson 分配,其參數為 λ 的一組隨機樣本,則此 Poisson 分配之標準差的最大概似估計量為何?
- (A) X
- (B) 0 .5 X
- (C) X2
- (D) X7 估計母體比例時,在 98%信賴水準下,要保證抽樣誤差不超過 3%,最少需要多少樣本?
正解:(D)
7X7 估計母體比例時,在 98%信賴水準下,要保證抽樣誤差不超過 3%,最少需要多少樣本?
- (A) 1068
- (B) 1508
- (C) 456
- (D) 5458 下列有關型 I 錯誤機率、型 II 錯誤機率、樣本數與檢定力的敘述,何者正確?
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
85458 下列有關型 I 錯誤機率、型 II 錯誤機率、樣本數與檢定力的敘述,何者正確?
- (A) 樣本數固定時,型 I 錯誤機率增加,則型 II 錯誤機率也增加
- (B) 型 I 錯誤機率不變,則樣本數增加時,型 II 錯誤機率減少
- (C) 型 I 錯誤機率不變,則樣本數增加時,檢定力減少
- (D) 樣本數增加時,型 I 錯誤機率減少,檢定力減少9 由兩常態母體中分別抽取大小為 15 與 17 的樣本,欲檢定兩母體變異數是否相等,則當 H 0 為真時,檢定統計量的抽樣分配為何?
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
9樣本數增加時,型 I 錯誤機率減少,檢定力減少9 由兩常態母體中分別抽取大小為 15 與 17 的樣本,欲檢定兩母體變異數是否相等,則當 H 0 為真時,檢定統計量的抽樣分配為何?
- (A) 自由度為 32 的卡方分配
- (B) 自由度為(15, 17)的 F 分配
- (C) 自由度為 30 的 t 分配
- (D) 自由度為(14, 16)的 F 分配10 在進行 3 個處理,15 個樣本的單因子變異數分析,已知 MSE = 5,SST(total) = 100,則檢定處理平均數差異的 F 統計量值為何?
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
10自由度為(14, 16)的 F 分配10 在進行 3 個處理,15 個樣本的單因子變異數分析,已知 MSE = 5,SST(total) = 100,則檢定處理平均數差異的 F 統計量值為何?
- (A) 2
- (B) 3
- (C) 4
- (D) 511 下列有關複迴歸分析的敘述何者正確?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
11511 下列有關複迴歸分析的敘述何者正確?
- (A) 解釋變數個數增加,則 R 2 就增加
- (B) 解釋變數個數增加,則 adj - R 2 就增加
- (C) 解釋變數個數減少, R 2 就增加
- (D) adj - R 2 一定大於 R 212 在一簡單線性迴歸問題中,已知 b1 = 2 , s x = 1.2 , s y = 3 ,則判定係數 R 2 的值為何?
正解:(A)
本題附有逐題詳解,線上作答後即可看到。
12adj - R 2 一定大於 R 212 在一簡單線性迴歸問題中,已知 b1 = 2 , s x = 1.2 , s y = 3 ,則判定係數 R 2 的值為何?
- (A) 0.6
- (B) 0.62
- (C) 0.64
- (D) 0.6613 迴歸分析中的殘差分析是用殘差來檢視迴歸模型中的隨機誤差是否符合建模時的假設條件,下列那一項不需要檢視?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
130.6613 迴歸分析中的殘差分析是用殘差來檢視迴歸模型中的隨機誤差是否符合建模時的假設條件,下列那一項不需要檢視?
- (A) 隨機誤差期望值為 0
- (B) 隨機誤差服從常態分配
- (C) 隨機誤差的變異數皆相同
- (D) 隨機誤差互相獨立14 給定下列時間數列資料:月 1 2 3 4 5 6 7 8 9 10 11 12數列值 21 19 23 21 29 28 26 27 28 28 30 32則 3 月的中心化 4 期移動平均值(Centered 4-period moving average)為何?
正解:(A)
本題附有逐題詳解,線上作答後即可看到。
14隨機誤差互相獨立14 給定下列時間數列資料:月 1 2 3 4 5 6 7 8 9 10 11 12數列值 21 19 23 21 29 28 26 27 28 28 30 32則 3 月的中心化 4 期移動平均值(Centered 4-period moving average)為何?
- (A) 21
- (B) 22
- (C) 23
- (D) 2415 由平均數為 130,標準差 21 之母體分配中抽取一組大小為 49 的隨機樣本,則樣本平均大於 136 的機率為:
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
152415 由平均數為 130,標準差 21 之母體分配中抽取一組大小為 49 的隨機樣本,則樣本平均大於 136 的機率為:
- (A) 0.0456
- (B) 0.0228
- (C) 0.0114
- (D) 0.005716 在某次流感流行期間,某地區預估流感病人中有 30%的病人為 A 型感冒,而另外 70%的病人為 B 型感冒。在 A 型感冒病人中有 70%的病人有發燒症狀,而 B 型感冒病人中有 35%的病人有發燒症狀。若一感冒病人有發燒症狀,則此病人:
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
160.005716 在某次流感流行期間,某地區預估流感病人中有 30%的病人為 A 型感冒,而另外 70%的病人為 B 型感冒。在 A 型感冒病人中有 70%的病人有發燒症狀,而 B 型感冒病人中有 35%的病人有發燒症狀。若一感冒病人有發燒症狀,則此病人:
- (A) 較有可能是 A 型感冒
- (B) 較有可能是 B 型感冒
- (C) 兩種感冒的可能性一致,即有 50%機會是 A 型感冒,而另外 50%機會是 B 型感冒
- (D) 無法判斷那種感冒較有可能17 從一母體隨機抽出 10 個資料來做母體平均 μ 的統計推論。如果採用以 t 分布為基礎的信賴區間以及t 統計量,則下列敘述何者錯誤﹖
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
17無法判斷那種感冒較有可能17 從一母體隨機抽出 10 個資料來做母體平均 μ 的統計推論。如果採用以 t 分布為基礎的信賴區間以及t 統計量,則下列敘述何者錯誤﹖
- (A) 使用 t 統計量來做 H 0 : μ = 3 對 H1 : μ ≠ 3 的 t 檢定,其假設為此母體是常態分布
- (B) 如果樣本標準差不為 0,所得到的 95%的信賴區間一定比 90%的信賴區間寬
- (C) 當檢定 H 0 : μ = 3 對 H1 : μ ≠ 3 ,如果 3 落在所得到的 90%的信賴區間,則在給定 5%的顯著水準下,t 檢定一定不拒絕 H 0
- (D) 檢定 H 0 : μ ≥ 3 對 H1 : μ < 3 及 H 0 : μ ≤ 3 對 H1 : μ > 3 這兩種單尾(one-tailed)檢定,所得到的兩個 t統計量值一樣18 某機構決定當其安全系統每月故障次數超過 1 次的機率大於 0.8 時,則必須更換此系統。如果此系統每月故障次數服從 Poisson 分配,請問此系統每月平均故障次數達到幾次時,此系統必須被更換?(指數 e = 2.718 )
正解:(C)
18檢定 H 0 : μ ≥ 3 對 H1 : μ < 3 及 H 0 : μ ≤ 3 對 H1 : μ > 3 這兩種單尾(one-tailed)檢定,所得到的兩個 t統計量值一樣18 某機構決定當其安全系統每月故障次數超過 1 次的機率大於 0.8 時,則必須更換此系統。如果此系統每月故障次數服從 Poisson 分配,請問此系統每月平均故障次數達到幾次時,此系統必須被更換?(指數 e = 2.718 )
- (A) 1 次
- (B) 1.5 次
- (C) 2 次
- (D) 3 次19 X 1 , X 2 ,..., X n1 是由平均值 μ1 之常態分配母體所抽得之隨機樣本,而 Y1 , Y2 ,..., Yn 2 是由平均值 μ2 之常態分配母體所抽得之隨機樣本。假定兩母體標準差為 σ1 及 σ 2 ,以下為比較 μ1 及 μ2 所用到之統計量:X −Y X −Y ( n1 − 1) S12 + ( n2 − 1) S 22T1 = , T2 = , S p2 = ,⎛1 1⎞ S12 S 22 n1 + n2 − 2S p2 ⎜⎜ + ⎟⎟ +⎝ n1 n2 ⎠ n1 n2∑i =1 ( X i − X )2 , S 2 = ∑i =1 (Yi − Y )2 , X = ∑i =1 X i , Y = ∑i =1Yi 。n1 n2 n1 n2S12 = 2n1 − 1 n2 − 1 n1 n2下列敘述何者正確?
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
193 次19 X 1 , X 2 ,..., X n1 是由平均值 μ1 之常態分配母體所抽得之隨機樣本,而 Y1 , Y2 ,..., Yn 2 是由平均值 μ2 之常態分配母體所抽得之隨機樣本。假定兩母體標準差為 σ1 及 σ 2 ,以下為比較 μ1 及 μ2 所用到之統計量:X −Y X −Y ( n1 − 1) S12 + ( n2 − 1) S 22T1 = , T2 = , S p2 = ,⎛1 1⎞ S12 S 22 n1 + n2 − 2S p2 ⎜⎜ + ⎟⎟ +⎝ n1 n2 ⎠ n1 n2∑i =1 ( X i − X )2 , S 2 = ∑i =1 (Yi − Y )2 , X = ∑i =1 X i , Y = ∑i =1Yi 。n1 n2 n1 n2S12 = 2n1 − 1 n2 − 1 n1 n2下列敘述何者正確?
- (A) 如果 σ 1 ≠ σ 2 ,則檢定 H 0 : μ1 = μ2 對 H1 : μ1 ≠ μ 2 使用統計量 T1
- (B) 如 果 σ 1 = σ 2 且 T1 值 為 − 2 , 則 檢 定 H 0 : μ1 ≤ μ2 對 H1 : μ1 > μ2 之 p 值 ( p-value ) 為1 − 0.5 P(| T (n1 + n2 − 2) |> 2) ,其中隨機變數 T (n1 + n2 − 2) 其分布為自由度 n1 + n2 − 2 的 t 分配S12 S 22 ⎛1 1⎞
- (C) 如果 σ 1 ≠ σ 2 ,則 + 及 S p2 ⎜⎜ + ⎟⎟ 都是隨機變數 X − Y 其變異數的估計量n1 n2 ⎝ n1 n2 ⎠
- (D) 如果 σ 1 ≠ σ 2 ,則檢定 H 0 : μ1 = μ2 對 H1 : μ1 ≠ μ 2 需用統計量 T2 且其在 H 0 成立下之分布為自由度n1 + n2 − 2 的 t 分配20 欲比較某工廠 3 條生產線所生產零件長度規格是否一致,在每條生產線各抽檢 6 個零件,所得抽檢零件長度平均值及變異數資料如下:生產線 1 生產線 2 生產線 3長度平均值33 35 34(單位:公分)長度變異數5 6 4(單位:公分 2)假如單因子變異數分析法(one-way ANOVA)用來檢定每條生產線所生產零件長度平均值一致,則:
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
20如果 σ 1 ≠ σ 2 ,則檢定 H 0 : μ1 = μ2 對 H1 : μ1 ≠ μ 2 需用統計量 T2 且其在 H 0 成立下之分布為自由度n1 + n2 − 2 的 t 分配20 欲比較某工廠 3 條生產線所生產零件長度規格是否一致,在每條生產線各抽檢 6 個零件,所得抽檢零件長度平均值及變異數資料如下:生產線 1 生產線 2 生產線 3長度平均值33 35 34(單位:公分)長度變異數5 6 4(單位:公分 2)假如單因子變異數分析法(one-way ANOVA)用來檢定每條生產線所生產零件長度平均值一致,則:
- (A) 所用之 F 統計量在 H 0 成立下之分布為 F 分配且分子自由度為 3,而分母自由度為 15
- (B) F 統計量值為 2.4
- (C) 每條生產線所生產之所有零件長度規格不一定要假設是常態分配
- (D) 變異數分析表(ANOVA table)所得到的兩種平方和(sum of squares)的值為 12 以及 7521 欲檢定三家高科技公司所生產之產品在今年市面上的占有率是否相等,即 p1 = p 2 = p3 = ,其中p1, p2 , p3 分別為這三家公司之市占率。隨機取得 900 名產品用戶資料如下:第一家公司 第二家公司 第三家公司用戶人數 275 275 350請問卡方(chi-squared)檢定統計量的值為:
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
21變異數分析表(ANOVA table)所得到的兩種平方和(sum of squares)的值為 12 以及 7521 欲檢定三家高科技公司所生產之產品在今年市面上的占有率是否相等,即 p1 = p 2 = p3 = ,其中p1, p2 , p3 分別為這三家公司之市占率。隨機取得 900 名產品用戶資料如下:第一家公司 第二家公司 第三家公司用戶人數 275 275 350請問卡方(chi-squared)檢定統計量的值為:
- (A) 3750
- (B) 100
- (C) 12.5
- (D) 22 x1 , x2 ,..., x10 為某公司 10 個星期每星期所打的電視廣告次數,而 y1 , y2 ,..., y10 為其每星期銷售量(100盒/單位),即 y1 = 5 ,則銷售量為 500 盒。 x1 , x2 ,..., x10 與 y1 , y2 ,..., y10 之共變異數(covariance)值為11,而相關係數(coefficient of correlation)值為 0.98。下列敘述何者錯誤?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
2222 x1 , x2 ,..., x10 為某公司 10 個星期每星期所打的電視廣告次數,而 y1 , y2 ,..., y10 為其每星期銷售量(100盒/單位),即 y1 = 5 ,則銷售量為 500 盒。 x1 , x2 ,..., x10 與 y1 , y2 ,..., y10 之共變異數(covariance)值為11,而相關係數(coefficient of correlation)值為 0.98。下列敘述何者錯誤?
- (A) 由共變異數值 11 可推估所打廣告次數與銷售量是正的線性相關
- (B) 相關係數 0.98 指出所打廣告次數與銷售量有高度線性相關x1 x2 x
- (C) 如果廣告次數的觀察值為平均每天的廣告次數,即資料值為 , ,..., 10 而 非 原 有 資 料 值7 7 7x1 , x2 ,..., x10 ,則平均每天廣告次數及銷售量之相關係數值為 0.14
- (D) 如 果 銷 售 量 之 單 位 改 為 每 單 位 1 盒 , 即 資 料 值 為 100 y1,100 y2 ,..., 100 y10 而 非 原 有 資 料 值y1 , y2 ,..., y10 ,則每週所打廣告次數及以盒為單位之銷售量的共變異數值為 110023 關於平均值 μ 及變異數為 σ 2 之常態分配的隨機變數 X ~ N ( μ , σ 2 ) ,則:
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
23如 果 銷 售 量 之 單 位 改 為 每 單 位 1 盒 , 即 資 料 值 為 100 y1,100 y2 ,..., 100 y10 而 非 原 有 資 料 值y1 , y2 ,..., y10 ,則每週所打廣告次數及以盒為單位之銷售量的共變異數值為 110023 關於平均值 μ 及變異數為 σ 2 之常態分配的隨機變數 X ~ N ( μ , σ 2 ) ,則:
- (A) 如果 X ~ N (4,1) ,則使機率值 P(c ≤ X ≤ c + 1) 最大之唯一可能 c 的值為 c = 4
- (B) 如果 X ~ N (1,2) ,則 P([ X − 1] ≤ 2) = 0.6826
- (C) 如果 X1 ~ N (2,1) 及 X 2 ~ N ( 2,2) ,則 P([ X 1 − 2] ≤ 1) = P([ X 2 − 2] ≤ 2)
- (D) 如果 X ~ N (4,9) ,則 P ([ X − 4] ≤ 6) = 0.977224 從一母體隨機抽出資料 x1 , x2 ,..., xn ,第一次抽出 100 個資料,也就是 n = 100 ,而第二次抽出 10000個資料也就是 n = 10000 。假設這兩組樣本其變異數的值非常接近(其比值接近 1),在相同信心水準(confidence level)下,利用這兩組樣本可做出兩個估計母體平均的信賴區間。則關於第一次抽樣做出信賴區間寬度對第二次抽樣做出信賴區間寬度的比值,下列敘述何者正確?
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
24如果 X ~ N (4,9) ,則 P ([ X − 4] ≤ 6) = 0.977224 從一母體隨機抽出資料 x1 , x2 ,..., xn ,第一次抽出 100 個資料,也就是 n = 100 ,而第二次抽出 10000個資料也就是 n = 10000 。假設這兩組樣本其變異數的值非常接近(其比值接近 1),在相同信心水準(confidence level)下,利用這兩組樣本可做出兩個估計母體平均的信賴區間。則關於第一次抽樣做出信賴區間寬度對第二次抽樣做出信賴區間寬度的比值,下列敘述何者正確?
- (A) 兩信賴區間寬度的比值與信心水準的值有關
- (B) 當信心水準是 0.95 時,兩信賴區間寬度的比值約是 100
- (C) 假如原先變異數值有誤,修正後的變異數值比較大且兩組樣本之修正後的變異數值依然非常接近(比值接近 1),則兩個修正後的信賴區間其寬度的比值變大
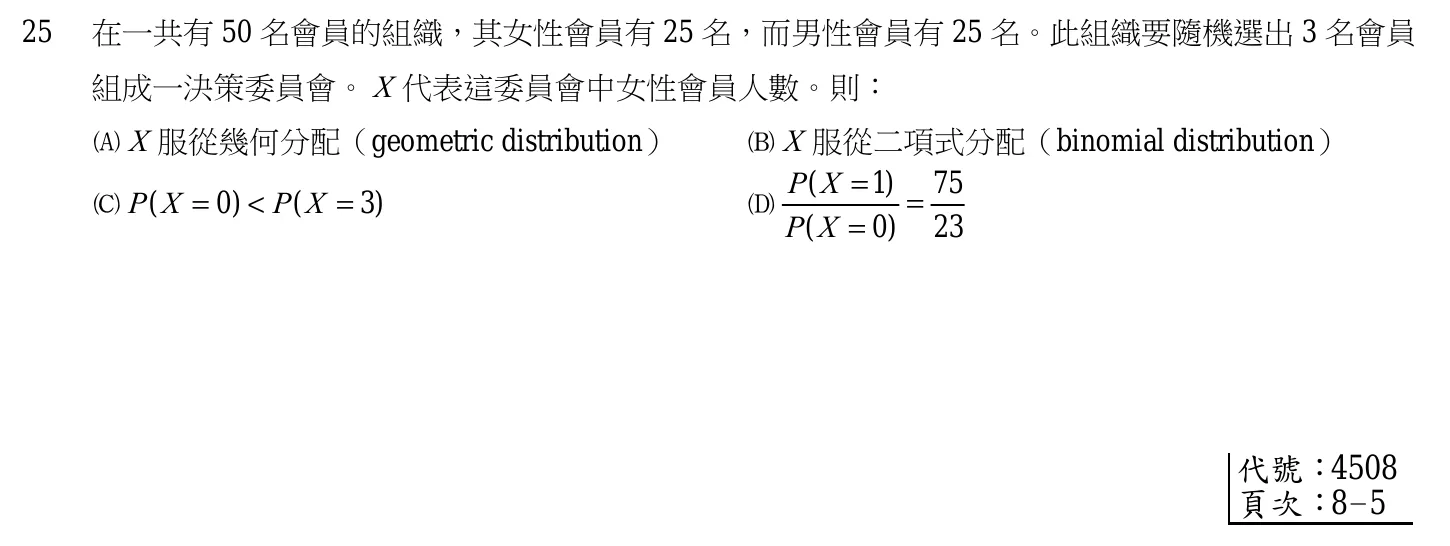
- (D) 當信心水準是 0.7 時,則兩信賴區間寬度的比值約是 1025 在一共有 50 名會員的組織,其女性會員有 25 名,而男性會員有 25 名。此組織要隨機選出 3 名會員組成一決策委員會。 X 代表這委員會中女性會員人數。則:
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
25(本題題幹與選項都在圖上,請見下圖作答)
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
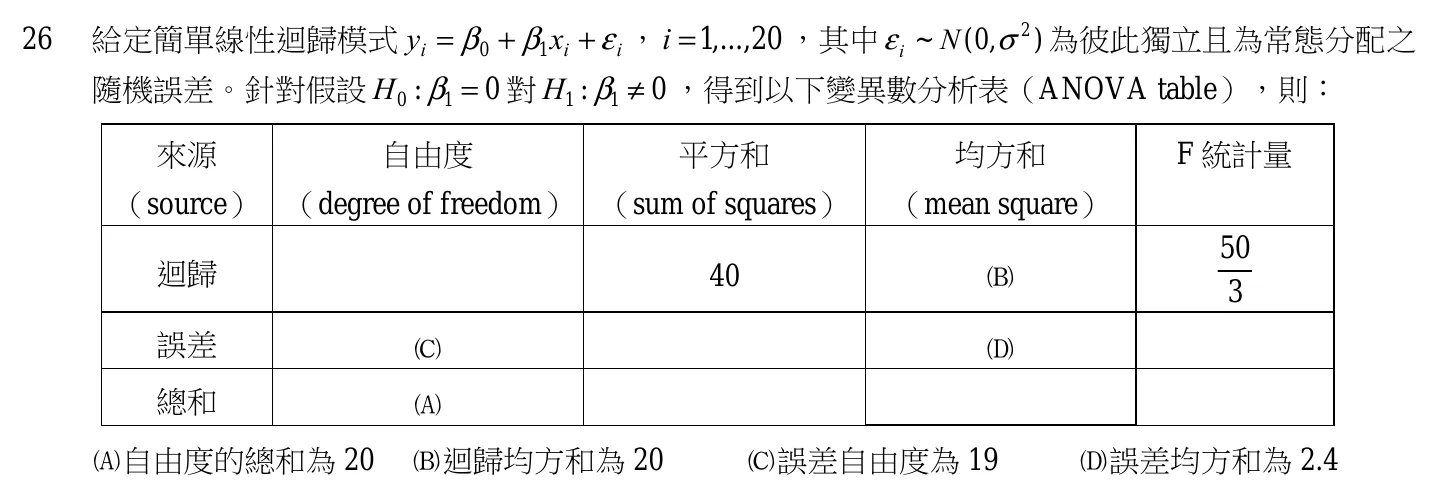
26(本題題幹與選項都在圖上,請見下圖作答)
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
27誤差均方和為 2.427 下表是調查廢除死刑這個議題的支持度是否無關性別所收集的資料:贊成廢除死刑人數 反對廢除死刑人數男性 30 70女性 40 60在虛無假設為贊成或反對廢除死刑之比率是無關性別,則:
- (A) 在虛無假設成立下,男性反對廢除死刑的預期數(expected value)為 60 人
- (B) 在虛無假設成立下,檢定統計量分布為自由度為 2 的卡方分配(chi-squared distribution)
- (C) 卡方(chi-squared)檢定統計量的值為
- (D) 在虛無假設成立下,女性贊成死刑的預期值與男性贊成死刑的預期值不同28 在一次有 2 位候選人且須選出 1 人的選舉中, p 為候選人甲的支持率, P 是樣本數為 n 的隨機樣本所得候選人甲的支持率。假定 np ≥ 5 , n(1 − p) ≥ 5 , n ≥ 100 ,且根據抽樣分布(sampling distribution)結果, P([ P − p] ≤ E ) = 0.95 ,其中 E 是誤差值。下列敘述何者錯誤?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
28在虛無假設成立下,女性贊成死刑的預期值與男性贊成死刑的預期值不同28 在一次有 2 位候選人且須選出 1 人的選舉中, p 為候選人甲的支持率, P 是樣本數為 n 的隨機樣本所得候選人甲的支持率。假定 np ≥ 5 , n(1 − p) ≥ 5 , n ≥ 100 ,且根據抽樣分布(sampling distribution)結果, P([ P − p] ≤ E ) = 0.95 ,其中 E 是誤差值。下列敘述何者錯誤?
- (A) 當 p 接近 0.5 時的誤差值要比 p 接近 0.1 或 0.9 的誤差值來得大,也就是選情激烈時的誤差值要比選情一面倒時的誤差值來得大
- (B) 當樣本數 n 增加時,誤差值會變小
- (C) 假如 P([ P − p] ≤ E*) = 0.9 ,則 E* > E
- (D) 根據中央極限定理, P 的抽樣分布近似常態分配29 某兩大棒球聯盟各推舉 1 名球員來競爭該年度的年度最佳打擊球員。假如這兩大聯盟球員的打擊率皆近似鐘形(bell-shaped)分布,相關資料如下表:推舉球員打擊率 該聯盟球員平均打擊率 該聯盟球員打擊率的標準差聯盟 A 0.35 0.25 0.025聯盟 B 0.4 0.3 0.05下列敘述何者正確?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
29根據中央極限定理, P 的抽樣分布近似常態分配29 某兩大棒球聯盟各推舉 1 名球員來競爭該年度的年度最佳打擊球員。假如這兩大聯盟球員的打擊率皆近似鐘形(bell-shaped)分布,相關資料如下表:推舉球員打擊率 該聯盟球員平均打擊率 該聯盟球員打擊率的標準差聯盟 A 0.35 0.25 0.025聯盟 B 0.4 0.3 0.05下列敘述何者正確?
- (A) 如果考慮推舉球員相對於其聯盟的表現並利用 z 分數(z-score)做為評斷標準,則聯盟 B 的推舉球員是年度最佳打擊球員
- (B) 聯盟 B 的推舉球員在其所屬聯盟是離群點(outlier)
- (C) 聯盟 A 的推舉球員在其所屬聯盟是離群點(outlier)
- (D) 聯盟 B 球員打擊率的變異係數(coefficient of variation)比聯盟 A 球員打擊率的變異係數小30 某型洗衣機的使用年數壽命可用一平均值為 15(年)之指數分配(exponential distribution)的隨機變數 X 來代表,則:
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
30聯盟 B 球員打擊率的變異係數(coefficient of variation)比聯盟 A 球員打擊率的變異係數小30 某型洗衣機的使用年數壽命可用一平均值為 15(年)之指數分配(exponential distribution)的隨機變數 X 來代表,則:
- (A) 這型洗衣機如果用了 9 年在下一年度報銷的機率和用了 18 年在下一年度報銷的機率一樣
- (B) X 的機率密度函數(probability density function)為 15e −15 x , x ≥ 0−
- (C) 此型洗衣機使用年數超過 20 年的機率為 1 − e 3−
- (D) 此型洗衣機使用壽命介於 10 年至 15 年之機率為 e −1 − e 331 X 是一離散型隨機變數(discrete random variable)且其機率函數(probability function)是 f (x) 。假定 X 的可能值是介於 0 與 10 之間,則:
正解:(A)
本題附有逐題詳解,線上作答後即可看到。
31此型洗衣機使用壽命介於 10 年至 15 年之機率為 e −1 − e 331 X 是一離散型隨機變數(discrete random variable)且其機率函數(probability function)是 f (x) 。假定 X 的可能值是介於 0 與 10 之間,則:
- (A) f (x) 的值可以是任何正數
- (B) ∫ f ( x)dx = 1∞∫
- (C) E ( X ) = xf ( x)dx
- (D) P( X = c) = f (c) ,其中 c 是 X 的可能值32 某機關員工的性別及是否在 10 年內升至主管職位的人數如下表:10 年內升至主管職 10 內未升至主管職男性員工 90 810女性員工 30 270若 M 代表男性員工, W 代表女性員工, S 代表員工 10 年內升至主管職,而 N 代表員工 10 年內未升至主管職,則:
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
32P( X = c) = f (c) ,其中 c 是 X 的可能值32 某機關員工的性別及是否在 10 年內升至主管職位的人數如下表:10 年內升至主管職 10 內未升至主管職男性員工 90 810女性員工 30 270若 M 代表男性員工, W 代表女性員工, S 代表員工 10 年內升至主管職,而 N 代表員工 10 年內未升至主管職,則:
- (A) P( M ) + P (W ) + P( S ) + P( N ) = 1
- (B) W 與 S 不是獨立事件(independent event)
- (C) 條件機率 P( M | N ) 等於 P(M )
- (D) M 與 W 為獨立事件(independent event)33 下列關於統計圖的敘述何者正確?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
33M 與 W 為獨立事件(independent event)33 下列關於統計圖的敘述何者正確?
- (A) 枝葉圖(stem and leaf plot)僅適用數值在百位之內的資料
- (B) 對質的資料(qualitative data)亦可用直方圖(histogram)來呈現
- (C) 長條圖(bar chart)中長條的高度僅能代表次數(frequency)不能代表相對次數(relative frequency)
- (D) 對於數量的資料(quantitative data)所摘要的累積次數(cumulative frequency)可用次數曲線圖(ogiveplot)呈現∑ ∑n nXi =1 i i =1( X i − X )234 X , X ,..., X , n > 1,為彼此獨立且具有相同分配的隨機變數, X =1 2 n ,及 S =,n n −1則下列敘述何者錯誤?
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
34對於數量的資料(quantitative data)所摘要的累積次數(cumulative frequency)可用次數曲線圖(ogiveplot)呈現∑ ∑n nXi =1 i i =1( X i − X )234 X , X ,..., X , n > 1,為彼此獨立且具有相同分配的隨機變數, X =1 2 n ,及 S =,n n −1則下列敘述何者錯誤?
- (A) 若 X1, X 2 ,..., X n 的分配為正態分配 N ( μ ,σ 2 ) ,則 X 為 μ 的不偏估計量(unbiased estimator)
- (B) 若 X1, X 2 ,..., X n 的分配為平均值 λ 的 Poisson 分配,則 X 2 − X 是 λ2 的不偏估計量(unbiased estimator)
- (C) 若 X 1 , X 2 ,..., X n 的分配為二項式分配(binomial distribution) B (m, p ) ,其中 m 是試驗次數, p 是成功機率,則 X 是 mp 的不偏估計量(unbiased estimator)
- (D) 若 X 1, X 2 ,..., xn 的分配為二項式分配(binomial distribution) B(1, p) ,即做一次試驗而成功機率為 p的二項式分配,則 S 2 是此二項式分配變異數的不偏估計量(unbiased estimator)35 對簡單線性迴歸模式 yi = βxi + ε i ,i = 1,...,6,其中 ε i ~ N (0,σ 2 ) 為彼此獨立且為常態分配之隨機誤差,所得之資料其相關資訊如下,則:6 6 6 6 6∑i =1xi = 6 , ∑ y = 3 , ∑ x = 10 , ∑ y = 3 , ∑ x y = 3 ,i =1ii =1ii =1ii =1i i
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
35若 X 1, X 2 ,..., xn 的分配為二項式分配(binomial distribution) B(1, p) ,即做一次試驗而成功機率為 p的二項式分配,則 S 2 是此二項式分配變異數的不偏估計量(unbiased estimator)35 對簡單線性迴歸模式 yi = βxi + ε i ,i = 1,...,6,其中 ε i ~ N (0,σ 2 ) 為彼此獨立且為常態分配之隨機誤差,所得之資料其相關資訊如下,則:6 6 6 6 6∑i =1xi = 6 , ∑ y = 3 , ∑ x = 10 , ∑ y = 3 , ∑ x y = 3 ,i =1ii =1ii =1ii =1i i
- (A) β 之最小平方估計量為 0
- (B) β 之最小平方估計量為 0.3∑ e = 0 其中 e 為第 i 個資料之殘差(residual)值
- (C) i =1 i i
- (D) 若 ryyˆ 是觀察值 y1, y2 ,..., y6 與配適值(fitted value)yˆ1, yˆ 2 ,..., yˆ 6 的相關係數(coefficient of correlation),則 ryyˆ > 036 考慮下列簡單線性迴歸模式 yi = β 0 + β1xi + ε i , i = 1,..., n ,其中 ε i ~ N (0,σ 2 ) 為彼此獨立且為常態分配之隨機誤差。b0 為 β 0 的最小平方估計量,b1 為 β1 的最小平方估計量, rxy 是 x1, x2 ,..., xn 與 y1, y2 ,..., yn 的相關係數(coefficient of correlation), ryyˆ 是觀察值 y1, y2 ,..., yn 與配適值(fitted value) yˆ1, yˆ 2 ,..., yˆ n 的相關係數,而 R 2 ≠ 0 為判定係數(coefficient of determination)。則下列敘述何者錯誤?
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
36若 ryyˆ 是觀察值 y1, y2 ,..., y6 與配適值(fitted value)yˆ1, yˆ 2 ,..., yˆ 6 的相關係數(coefficient of correlation),則 ryyˆ > 036 考慮下列簡單線性迴歸模式 yi = β 0 + β1xi + ε i , i = 1,..., n ,其中 ε i ~ N (0,σ 2 ) 為彼此獨立且為常態分配之隨機誤差。b0 為 β 0 的最小平方估計量,b1 為 β1 的最小平方估計量, rxy 是 x1, x2 ,..., xn 與 y1, y2 ,..., yn 的相關係數(coefficient of correlation), ryyˆ 是觀察值 y1, y2 ,..., yn 與配適值(fitted value) yˆ1, yˆ 2 ,..., yˆ n 的相關係數,而 R 2 ≠ 0 為判定係數(coefficient of determination)。則下列敘述何者錯誤?
- (A) 如果 rxy > 0 ,則 b1 > 0
- (B) 如果 b1 < 0 ,則 ryyˆ = − R 2
- (C) 如果 yˆi = yi ,則 R 2 = rxy2 = 1
- (D) R 2 = rxy2 = ry2yˆ37 下列 100 組父親身高及其小孩身高的資料: ( xi , yi ) , i = 1,...,100 ,其中 xi 為父親身高而 yi 為其小孩身高。給定簡單線性迴歸模式 yi = β 0 + β1xi + ε i , i = 1,...,100 ,其中 ε i ~ N (0,σ 2 ) 為彼此獨立且為常態分配之隨機誤差。假定所得之迴歸關係式為 yˆ = b0 + b1x ,其中 b0 及 b1 為 β 0 及 β1 的最小平方估計量且∑ x ∑ y100 100b1 = 。 x = i =1 i 是平均父親身高而 y = i =1 i 是平均小孩身高。則根據迴歸關係式:3 100 100
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
37R 2 = rxy2 = ry2yˆ37 下列 100 組父親身高及其小孩身高的資料: ( xi , yi ) , i = 1,...,100 ,其中 xi 為父親身高而 yi 為其小孩身高。給定簡單線性迴歸模式 yi = β 0 + β1xi + ε i , i = 1,...,100 ,其中 ε i ~ N (0,σ 2 ) 為彼此獨立且為常態分配之隨機誤差。假定所得之迴歸關係式為 yˆ = b0 + b1x ,其中 b0 及 b1 為 β 0 及 β1 的最小平方估計量且∑ x ∑ y100 100b1 = 。 x = i =1 i 是平均父親身高而 y = i =1 i 是平均小孩身高。則根據迴歸關係式:3 100 100
- (A) 如果一父親身高比 x 高 15 公分,則預測其小孩身高比 y 高但沒有高到 15 公分
- (B) 如果一父親身高比 x 矮 15 公分,則預測其小孩身高比 y 矮 10 公分
- (C) 如果 x = 165 , y = 165 ,則一父親身高 156 公分,預測其小孩身高為 153 公分
- (D) 假定 b1 的值是 1 而非 。如果一父親身高比 x 矮 15 公分,預測其小孩身高並不會比 y 矮 15 公分38 為檢定兩母體比例 p1 與 p 2 是否相等,由兩母體中分別抽取大小為 400 的樣本,已知pෝ1 = 0.6,pෝ2 = 0.5 ,則檢定統計量的值為何?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
38假定 b1 的值是 1 而非 。如果一父親身高比 x 矮 15 公分,預測其小孩身高並不會比 y 矮 15 公分38 為檢定兩母體比例 p1 與 p 2 是否相等,由兩母體中分別抽取大小為 400 的樣本,已知pෝ1 = 0.6,pෝ2 = 0.5 ,則檢定統計量的值為何?
- (A) 80.81
- (B) 5.71
- (C) 2.84
- (D) 40.2039 X1 , X 2 , ..., X n 為來自均勻分配 U (0,θ ) 的一組隨機樣本,則 θ 的動差估計量為何?
正解:(C)
本題附有逐題詳解,線上作答後即可看到。
3940.2039 X1 , X 2 , ..., X n 為來自均勻分配 U (0,θ ) 的一組隨機樣本,則 θ 的動差估計量為何?
- (A) 0 .5 X
- (B) X
- (C) max (X1 , X 2 , ..., X n )
- (D) 2X40 在單因子變異數分析中,Tukey 多重比較的目的為何?
正解:(D)
本題附有逐題詳解,線上作答後即可看到。
402X40 在單因子變異數分析中,Tukey 多重比較的目的為何?
- (A) 檢定所有母體是否具常態性
- (B) 檢定所有成對母體平均數是否有差異
- (C) 檢定所有母體平均數是否有差異
- (D) 檢定所有母體變異數是否有差異附表:標準常態累加機率值表P( 0 < Z < z ) = α α0 z Z
正解:(B)
本題附有逐題詳解,線上作答後即可看到。
初等考試 統計學大意 其他年度
- 115 年 初等考試 統計學大意(40 題)
- 113 年 初等考試 統計學大意(40 題)
- 112 年 初等考試 統計學大意(40 題)
- 111 年 初等考試 統計學大意(40 題)
- 109 年 初等考試 統計學大意(40 題)
- 108 年 初等考試 統計學大意(40 題)
- 106 年 初等考試 統計學大意(40 題)
- 105 年 初等考試 統計學大意(40 題)
- 104 年 初等考試 統計學大意(40 題)
- 103 年 初等考試 統計學大意(40 題)
- 102 年 初等考試 統計學大意(40 題)
題目與標準答案來源:考選部考畢試題查詢平臺(政府資訊公開資料)。最後更新:。